
Automatyzacja AI · Picvelo · 2026 · 8 miesięcy (rozwijany)
Auto-blog Picvelo - redakcja w Pull Requestach
64 artykuły na produkcji przy koszcie ~$0.04 za sztukę i zerowej liczbie publikacji, których nikt nie przeczytał przed wypuszczeniem - każdy tekst przechodzi przez Pull Requesta.
- Python
- GPT-4o
- SQLite
- Unsplash API
- GitHub Actions
- PHP
Wyzwanie
Picvelo to młoda platforma SaaS z domeną bez historii - bez treści nie miała szans na ruch organiczny. Pierwsza wersja bota publikowała dwa artykuły dziennie w trzech językach i po 74 wpisach dała trzy kliknięcia. Dane z Search Console pokazały dlaczego: teksty edukacyjne o fotografii rankowały na pozycjach 40-90, wersje EN i DE zebrały 389 wyświetleń przy zerowej liczbie kliknięć, a rachunek za tokeny rósł liniowo z długością artykułów.
Nasze rozwiązanie
Przebudowaliśmy pipeline pod dane, nie pod objętość. Tłumaczenia wyłączone, długość ścięta z 2100 do 1100 słów, dwa sloty dziennie zamienione na jeden, a pula tematów zawężona w 100% do klastra komercyjnego - galerie klienckie, dostawa zdjęć, proofing, biznes fotografa - czyli long-tail zgodny z produktem, gdzie te same dane GSC pokazywały pozycje 17-27. Publikacja idzie przez Pull Requesta z labelkami, więc żaden tekst nie trafia na stronę bez decyzji człowieka.
64
Artykułów live
~$0.04
Koszt artykułu
0
Publikacji bez review
Co zbudowaliśmy
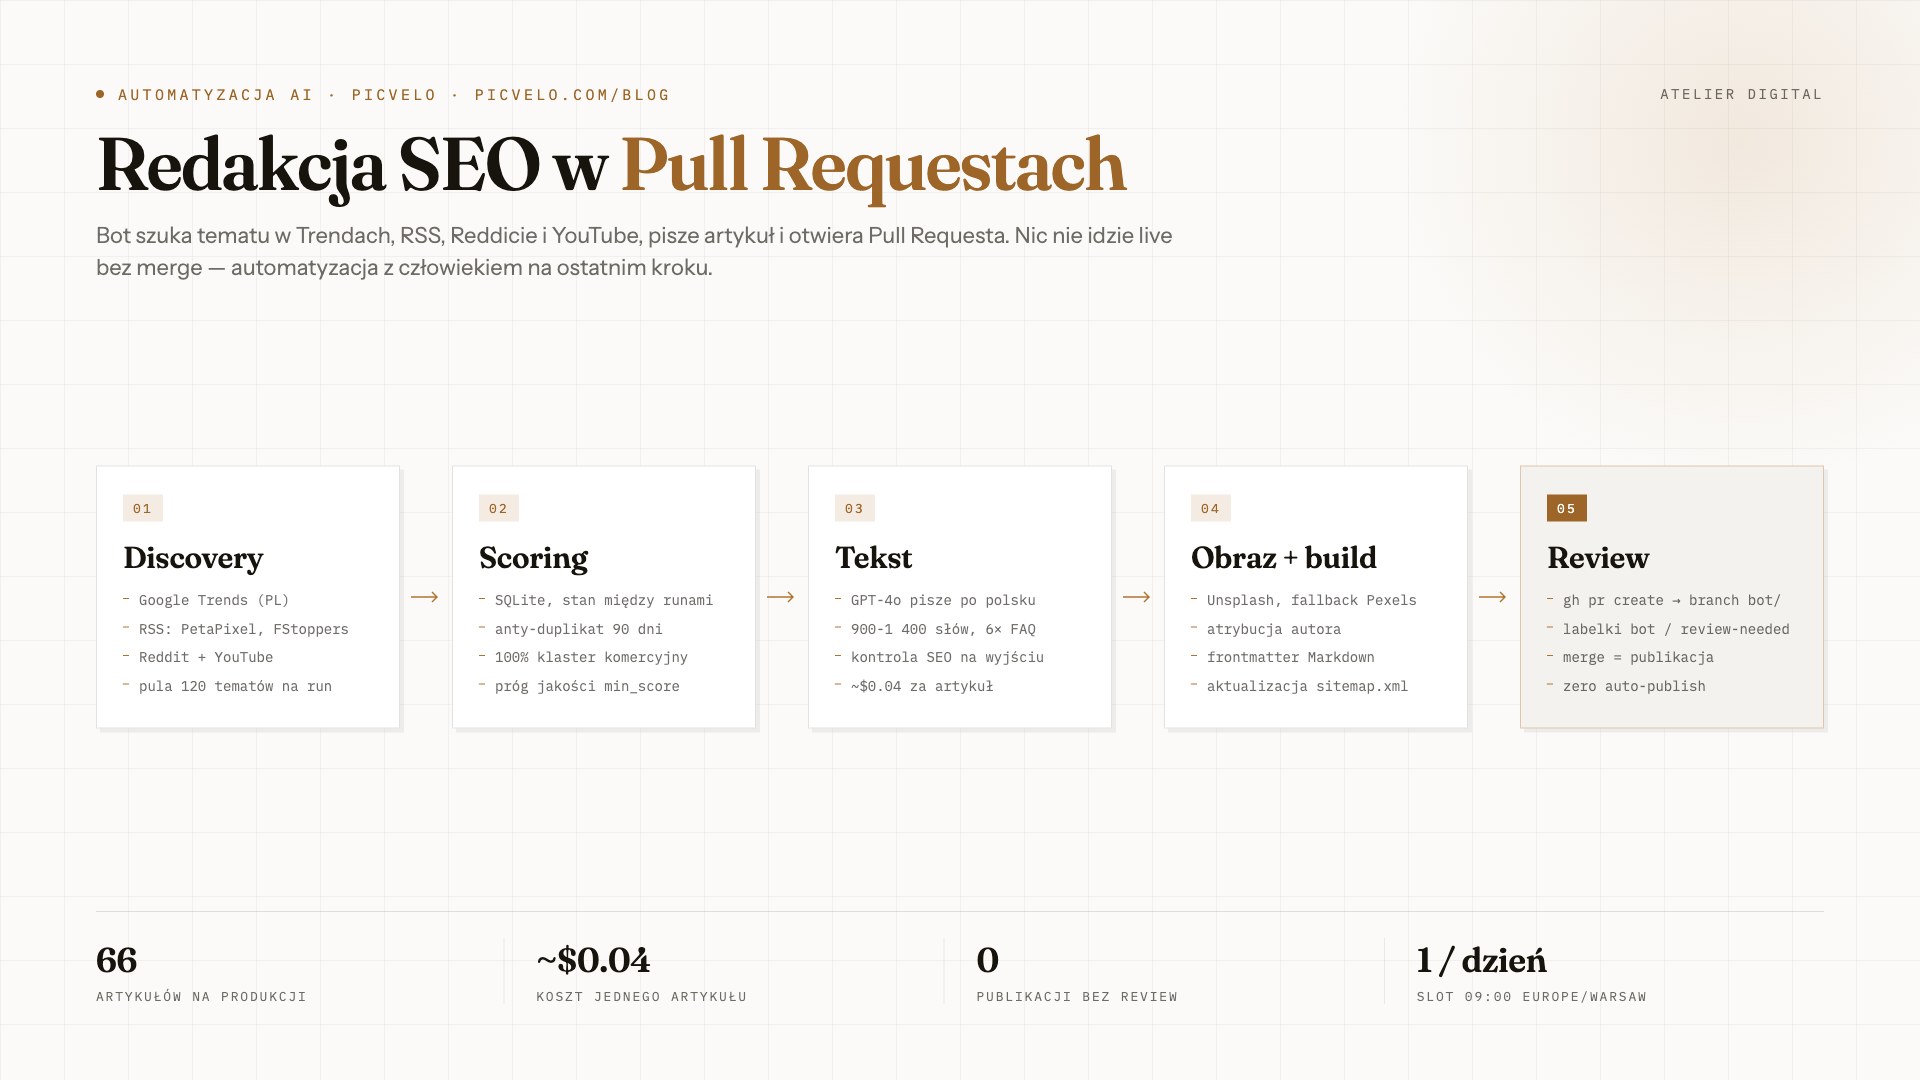
- 01 Discovery z Google Trends, RSS, Reddita i YouTube
- 02 Scoring i deduplikacja w SQLite (okno 90 dni)
- 03 Pula 120 tematów na run - żaden temat nie ginie w losowaniu
- 04 Artykuł GPT-4o, 900-1400 słów, 6 pytań FAQ
- 05 Hero z Unsplash z atrybucją, fallback na Pexels
- 06 Markdown + automatyczna aktualizacja sitemap.xml
- 07 Publikacja przez Pull Requesta - zero auto-publish
- 08 Silnik bloga w PHP z JSON-LD i RSS
Spis treści +
O projekcie
Picvelo to nasza własna platforma dla fotografów - o tym, jak w ogóle powstała, piszemy w tekście o budowie SaaS-a. Blog miał ją wypozycjonować na zapytania, które zadają fotografowie szukający narzędzia do galerii i selekcji zdjęć - a nie ogólne hasła o fotografii, gdzie konkuruje pół internetu.
Ten projekt jest w portfolio głównie dlatego, że pokazuje, co automatyzacja treści robi źle, zanim zacznie robić dobrze.
Czego nauczyły nas dane
Więcej ≠ lepiej
Pierwsza konfiguracja: dwa artykuły dziennie, po 2100 słów, tłumaczone na angielski i niemiecki. Po 74 wpisach - trzy kliknięcia z wyszukiwarki. Search Console pokazała, że teksty edukacyjne (“trójkąt ekspozycji”, “jak ustawić ISO”) siedzą na pozycjach 40-90, bo młoda domena nie ma czym konkurować z serwisami o dziesięcioletniej historii.
Tłumaczenia były stratą
Wersje EN i DE zebrały przez 90 dni 389 wyświetleń i zero kliknięć przy średniej pozycji 43. Wyłączyliśmy translator - konfiguracja została w kodzie, więc przywrócenie to zmiana jednej listy, gdy domena urośnie.
Długość to jedyny realny driver kosztu
Tokeny wyjściowe kosztują kilkukrotnie więcej niż wejściowe. Skrócenie artykułu z 2100 do 1100 słów zbiło rachunek o połowę i nie ruszyło pozycji ani o oczko - bo nie długość była powodem, dla którego blog nie rankował.
Klaster komercyjny zamiast edukacji
Pula tematów została zawężona do treści pod realnych klientów produktu: galerie klienckie, przekazywanie zdjęć, proofing, sprzedaż odbitek, prowadzenie biznesu fotograficznego. Te same dane GSC pokazywały dla nich pozycje 17-27 zamiast 40-90.
Jak działa dzisiaj
Raz dziennie, o 9:00 czasu warszawskiego, bot zbiera tematy z Google Trends, RSS-ów branżowych (PetaPixel, FStoppers, Optyczne), Reddita i YouTube, dorzuca do tego pulę 120 tematów evergreenowych i punktuje wszystko razem. Stan trzyma w SQLite - dedup patrzy wstecz na całą historię publikacji, więc temat nie wraca. GPT-4o pisze tekst po polsku, kontrola SEO sprawdza wyjście, Unsplash dokłada hero z atrybucją autora.
Gotowy artykuł ląduje w Pull Requeście na gałęzi bot/YYYY-MM-DD-slot-N, z labelkami bot, blog i review-needed. Merge jest publikacją. Bot nie ma prawa zapisu na produkcję.
Co z tego wyszło
Sześćdziesiąt cztery artykuły na produkcji, koszt rzędu czterech centów za sztukę i zero publikacji, które poszły na stronę bez przeczytania - to jest zmierzone.
Trzeba za to powiedzieć dokładnie, czym są liczby 40-90 i 17-27, bo łatwo zrobić z nich coś, czym nie są. To nie jest przyrost w czasie. Search Console pokazała jednocześnie dwie rzeczy: teksty edukacyjne o fotografii siedziały na pozycjach 40-90, a tematy z klastra komercyjnego na 17-27. Zawęziliśmy pulę do tych drugich, bo dane mówiły, gdzie ta domena ma szansę. To jest decyzja podjęta na pomiarze, a nie zmierzona poprawa po decyzji.
Czego nie wiemy: Search Console pokazuje pozycję i wyświetlenia, nie mówi, ile z tych wejść skończyło się założeniem konta w Picvelo albo płatną subskrypcją - to wymagałoby spięcia rejestracji z konkretnym artykułem, czego to wdrożenie nie robi. Blog jest młody i ruch na long-tailu rośnie powoli. To, co mamy, to pipeline, który dobiera tematy z danych zamiast z wyobraźni. Czy to przełożyło się na rejestracje w Picvelo, jeszcze nie wiemy. Ten pipeline, tak jak automatyzacja AI dla firm, którą budujemy dla innych klientów, działa dobrze dopiero wtedy, gdy karmi się go danymi, a nie objętością.
Technicznie
Python na GitHub Actions po stronie bota, PHP po stronie silnika bloga - parser frontmattera, routing /blog/{slug}, JSON-LD i RSS. Stan i deduplikacja w SQLite. Modele: GPT-4o do pisania (mini nie trafiał w długość po polsku - trzy dry-runy dały 803, 886 i 776 słów przy briefie na 1800+), gpt-4o-mini do zadań researchowych.
Zrzuty ekranu
Podobny problem do rozwiązania?
Napisz krótko, o co chodzi — wycena wraca w 24 godziny.
Zapytaj o wycenę →